

Intelligenza artificiale e psicologia clinica
Negli ultimi anni l’intelligenza artificiale (IA) è entrata nella vita quotidiana di milioni di persone. Dalla scrittura di testi alla traduzione automatica, fino ai sistemi di supporto alle decisioni in ambito sanitario, queste tecnologie stanno modificando profondamente il nostro modo di lavorare e di accedere alle informazioni.
Anche la psicologia clinica sta iniziando a confrontarsi con questa trasformazione. Può un algoritmo aiutare uno psicoterapeuta a formulare una diagnosi? Può individuare precocemente un disturbo o suggerire il trattamento più appropriato? E, soprattutto, quali sono i limiti di questi strumenti?
Per rispondere a queste domande è necessario distinguere l’intelligenza artificiale dai sistemi di machine learning (ML), uno dei suoi principali ambiti di applicazione. Nato nell’ambito della ricerca sull’intelligenza artificiale, a partire dalle riflessioni pionieristiche di Turing (1950), il machine learning comprende algoritmi capaci di apprendere dai dati, riconoscere schemi ricorrenti e utilizzare le conoscenze acquisite per affrontare situazioni nuove (Alzubi et al., 2018; Barbierato & Gatti, 2024).
Negli ultimi anni, la disponibilità di grandi quantità di dati clinici e l’aumento della potenza di calcolo hanno favorito una rapida evoluzione di questi modelli, rendendoli applicabili in numerosi ambiti, tra cui la medicina e la salute mentale (Abiodun et al., 2018; Shatte et al., 2019).
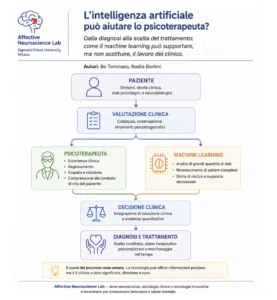
È importante chiarire, tuttavia, che l’obiettivo dell’intelligenza artificiale non è sostituire il terapeuta. Piuttosto, queste tecnologie possono rappresentare strumenti di supporto al ragionamento clinico, aiutando il professionista a integrare grandi quantità di informazioni e a riconoscere pattern difficilmente individuabili dall’osservazione umana. La decisione clinica, la relazione terapeutica e la comprensione della storia del paziente rimangono, infatti, competenze profondamente umane.
Come “imparano” gli algoritmi?
Per comprendere come il machine learning possa supportare il lavoro dello psicoterapeuta è utile capire, in modo molto semplice, come funzionano questi algoritmi.
A differenza dei programmi tradizionali, che seguono istruzioni prestabilite, i modelli di machine learning apprendono direttamente dai dati, individuando relazioni e schemi che possono poi utilizzare per analizzare nuove situazioni (Alzubi et al., 2018).
Esistono numerosi algoritmi, ma la maggior parte può essere ricondotta a due grandi categorie: apprendimento supervisionato (Supervised Learning, SL)e apprendimento non supervisionato (Unsupervised Learning, UL) (Alzubi et al., 2018).
Nel primo caso, l’algoritmo viene addestrato utilizzando dati già classificati. Ad esempio, può imparare a distinguere pazienti con e senza depressione analizzando migliaia di casi per i quali la diagnosi è già nota. Nel secondo caso, invece, il modello riceve dati privi di etichette e cerca autonomamente di individuare gruppi o caratteristiche comuni, evidenziando pattern che potrebbero non essere immediatamente riconoscibili dal clinico (Alzubi et al., 2018).
Questi approcci trovano applicazione in diverse fasi del percorso clinico. I modelli supervisionati possono contribuire, ad esempio, alla diagnosi differenziale o alla stima del rischio di sviluppare un disturbo, mentre quelli non supervisionati possono aiutare a identificare sottogruppi di pazienti con caratteristiche simili o differenti modalità di risposta ai trattamenti (Shatte et al., 2019).
Un esempio concreto: il Disturbo Depressivo Maggiore
Per comprendere meglio come il machine learning possa supportare la pratica clinica, può essere utile considerare una delle sue applicazioni più studiate: il Disturbo Depressivo Maggiore (DDM).
Il DDM è uno dei disturbi mentali più diffusi e invalidanti, caratterizzato da umore depresso, perdita di interesse o piacere nelle attività quotidiane e da una serie di sintomi cognitivi, emotivi e fisici che compromettono significativamente il funzionamento della persona (American Psychiatric Association [APA], 2022). La sua elevata diffusione e la complessità dei meccanismi che lo caratterizzano ne fanno un ambito particolarmente interessante per lo sviluppo di strumenti basati sull’intelligenza artificiale.
Negli ultimi anni, le neuroscienze hanno contribuito a comprendere meglio le basi biologiche della depressione, evidenziando alterazioni che coinvolgono diversi circuiti cerebrali e sistemi neurobiologici (Dean & Keshavan, 2017; Ferrari & Villa, 2016). Queste conoscenze derivano soprattutto dagli studi di neuroimaging, ottenuti attraverso tecniche come la risonanza magnetica strutturale e funzionale (sMRI e fMRI), la tomografia a emissione di positroni (PET) e la diffusion tensor imaging (DTI) (Arnone et al., 2014). Anche l’elettroencefalogramma (EEG) si è dimostrato una fonte promettente di biomarcatori, mostrando alterazioni dell’attività cerebrale associate al disturbo (De Aguiar Neto & Rosa, 2019; Steiger & Kimura, 2009).
È proprio in questo contesto che il machine learning trova una delle sue applicazioni più promettenti. Algoritmi come le Support Vector Machines (SVM) o le Artificial Neural Networks (ANN) possono analizzare grandi quantità di dati neurobiologici, individuando pattern associati alla depressione e contribuendo a distinguere pazienti con DDM da soggetti senza il disturbo (Arnone et al., 2014; Shatte et al., 2019).
Naturalmente, questi sistemi non formulano una diagnosi in modo autonomo. Piuttosto, rappresentano strumenti di supporto che possono integrare il ragionamento clinico, offrendo al professionista informazioni aggiuntive utili nel processo diagnostico.
Come viene addestrato un modello di machine learning?
Ma come fa, concretamente, un algoritmo a riconoscere la depressione?
Il processo inizia molto prima che il modello venga utilizzato nella pratica clinica. Dopo aver sviluppato l’algoritmo, i ricercatori lo addestrano utilizzando grandi quantità di dati provenienti sia da persone con Disturbo Depressivo Maggiore sia da soggetti senza il disturbo.
Durante questa fase, il modello analizza progressivamente ogni caso, confrontando le proprie previsioni con la diagnosi reale. Ogni errore rappresenta un’opportunità di apprendimento: l’algoritmo modifica i propri parametri, migliora progressivamente le sue prestazioni e ripete questo processo migliaia di volte, fino a raggiungere un livello di accuratezza soddisfacente (Alzubi et al., 2018).
Una volta completato l’addestramento, il modello viene messo alla prova con dati provenienti da pazienti che non ha mai “visto” in precedenza. È proprio questa fase di validazione che permette di valutare quanto il sistema sia realmente in grado di riconoscere nuovi casi di depressione, misurandone accuratezza, sensibilità e specificità (Shatte et al., 2019).
Naturalmente, un’elevata accuratezza non è sufficiente perché un algoritmo possa essere utilizzato nella pratica clinica. I risultati devono essere confermati da studi indipendenti e dimostrare di offrire un beneficio reale al lavoro dello psicoterapeuta e del medico, integrandosi con il giudizio clinico senza sostituirlo.
Uno strumento, non un sostituto
Le applicazioni del machine learning in psicologia clinica sono in continua evoluzione e i risultati ottenuti finora appaiono promettenti. La ricerca sta cercando di comprendere con sempre maggiore precisione quanto questi modelli siano affidabili nel supportare la diagnosi, prevedere l’evoluzione dei disturbi e contribuire alla scelta degli interventi più appropriati.
Allo stesso tempo, è importante evitare aspettative irrealistiche. L’intelligenza artificiale non è in grado di comprendere la complessità dell’esperienza umana, né può sostituire competenze fondamentali come il ragionamento clinico, l’empatia o la costruzione dell’alleanza terapeutica.
Il valore di queste tecnologie risiede piuttosto nella loro capacità di analizzare grandi quantità di dati, individuare pattern difficilmente riconoscibili dall’occhio umano e fornire informazioni aggiuntive che possano supportare il professionista nelle sue decisioni.
In questa prospettiva, il futuro della psicologia clinica non sembra orientato verso una contrapposizione tra terapeuta e intelligenza artificiale, ma verso una collaborazione in cui la tecnologia rappresenta uno strumento al servizio del clinico. Sarà proprio l’integrazione tra innovazione tecnologica, competenza professionale e relazione terapeutica a determinare il reale contributo dell’intelligenza artificiale alla salute mentale.